

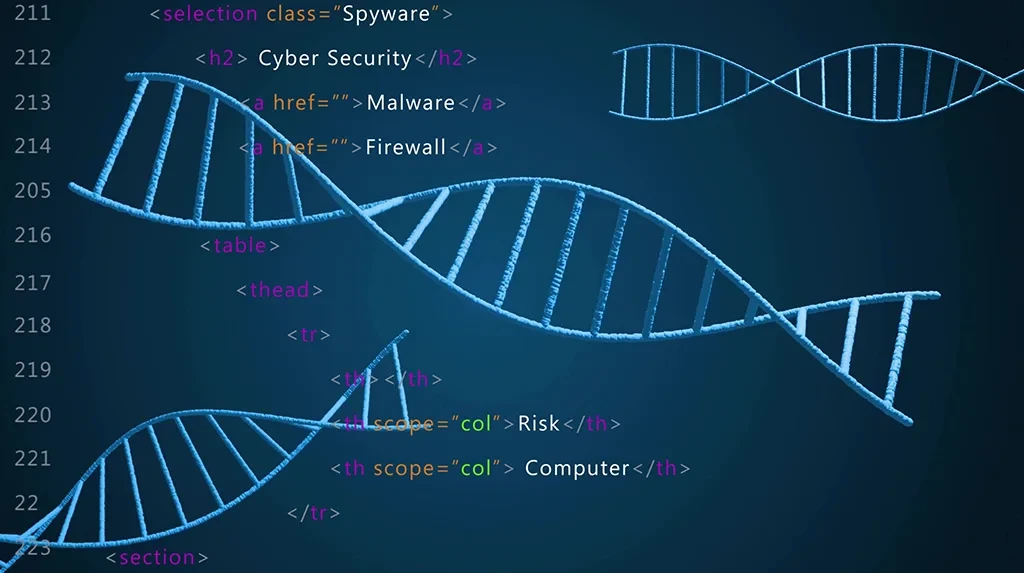
- DNA jako cyfrowy nośnik danych: Zasady azotowe (A, T, C, G) można przełożyć na ciąg binarny (zera i jedynki), co pozwala wykorzystać syntetyczną nić DNA do zapisania złośliwego kodu zamiast zwykłych informacji biologicznych.
- Mechanizm ataku (przepełnienie bufora): Podczas sekwencjonowania dane z próbki trafiają do komputera jako dane wejściowe; brak ich odpowiedniej weryfikacji pozwolił na przepełnienie bufora pamięci i wykonanie złośliwego kodu po stronie oprogramowania analitycznego.
- Koncept akademicki, a nie realne zagrożenie: Badanie było przeprowadzone w sterylnych warunkach z celowo osłabionymi zabezpieczeniami aplikacji, co oznacza, że ataki z probówki nie stanowią obecnie masowego zagrożenia dla laboratoriów.
- Zasada braku zaufania do danych wejściowych: Eksperyment przypomina kluczową regułę cyberbezpieczeństwa – każdy system (zarówno sekwencer DNA, jak i sterownik w energetyce czy automatyce) musi traktować dane napływające ze świata fizycznego jako potencjalnie niebezpieczne.
- Wzrost ryzyka wraz z automatyzacją: Taniejące sekwencjonowanie i cyfryzacja branży biotechnologicznej sprawiają, że laboratoria muszą stosować standardowe praktyki IT: regularne aktualizacje, kontrolę danych, izolację sieci oraz audyty bezpieczeństwa oprogramowania.
Cyberbezpieczeństwo kojarzy się najczęściej z komputerami, serwerami, sieciami, hasłami i złośliwymi linkami. Tymczasem naukowcy z University of Washington pokazali eksperyment, który brzmi jak połączenie biologii molekularnej z filmem o hakerach. Zakodowali złośliwe oprogramowanie w syntetycznej nici DNA i sprawdzili, czy komputer analizujący próbkę może zostać w ten sposób zaatakowany.
To nie oznacza, że od jutra laboratoria genetyczne będą padać ofiarą „wirusów z probówki”. Eksperyment był mocno kontrolowany, a badacze celowo osłabili część zabezpieczeń oprogramowania, aby pokazać możliwy kierunek zagrożenia.
Mimo to sam pomysł jest ważny. Pokazuje, że w świecie coraz bardziej zautomatyzowanych laboratoriów, taniego sekwencjonowania DNA i ogromnych baz danych biologicznych cyberbezpieczeństwo nie kończy się na firewallu i aktualizacji Windowsa.
Jak można zapisać dane w DNA?
Nić DNA składa się z czterech zasad azotowych: adeniny, tyminy, cytozyny i guaniny, oznaczanych literami A, T, C oraz G. To właśnie ich kolejność niesie informację biologiczną.
Z punktu widzenia informatyki DNA można potraktować także jako nośnik danych. Skoro komputer zapisuje informacje w postaci zer i jedynek, to odpowiedni algorytm może przełożyć ciąg binarny na sekwencję liter A, T, C i G.
To nie jest science fiction. Naukowcy od lat badają możliwość przechowywania danych w DNA, bo taki nośnik ma ogromną gęstość zapisu i może przetrwać bardzo długo w odpowiednich warunkach.
W tym przypadku badacze wykorzystali tę samą logikę, ale w mniej przyjemnym kierunku: zamiast neutralnych danych zakodowali w DNA fragment złośliwego kodu.
Od próbki do komputera
W normalnym procesie laboratoryjnym próbka DNA jest sekwencjonowana, czyli odczytywana przez specjalistyczne urządzenie. Następnie dane trafiają do komputera, gdzie oprogramowanie analizuje sekwencję i przetwarza ją na cyfrowy zapis.
I właśnie ten etap był kluczowy.
Badacze przygotowali syntetyczną nić DNA zawierającą odpowiednio zakodowany ciąg danych. Po odczycie próbki komputer potraktował wynik jak dane wejściowe. W specjalnie przygotowanych warunkach doprowadziło to do wykorzystania błędu w oprogramowaniu analizującym sekwencję.
Innymi słowy: biologiczna próbka stała się nośnikiem danych, a dane uruchomiły podatność po stronie programu.
To brzmi dziwnie tylko na pierwszy rzut oka. W praktyce komputery od lat atakowane są przez źle obsłużone dane wejściowe: pliki graficzne, dokumenty PDF, archiwa, pakiety sieciowe czy kody QR. Tutaj nietypowy był po prostu nośnik.
Kluczowy mechanizm: przepełnienie bufora
W eksperymencie wykorzystano znaną klasę podatności określaną jako przepełnienie bufora.
Dochodzi do niej wtedy, gdy program próbuje zapisać więcej danych, niż przewidziano w danym obszarze pamięci. Jeżeli aplikacja nie kontroluje tego poprawnie, dodatkowe dane mogą nadpisać sąsiednie fragmenty pamięci i doprowadzić do nieprzewidzianego działania programu.
W skrajnych przypadkach taka podatność może pozwolić atakującemu na wykonanie własnego kodu.
To stary problem informatyki, ale wciąż bardzo istotny. Różnica polega na tym, że tutaj błędne dane nie przyszły z internetu, lecz zostały odczytane z materiału biologicznego.
I właśnie dlatego eksperyment przyciągnął uwagę świata cyberbezpieczeństwa.
To nie był realistyczny atak na laboratorium
Warto jasno zaznaczyć: pokaz University of Washington nie oznacza, że każdy może dziś kupić DNA w internecie i włamać się do dowolnego laboratorium.
Eksperyment był bardzo trudny do przeprowadzenia. Naukowcy przygotowali kontrolowane środowisko, zmodyfikowali warunki testu i wyłączyli część zabezpieczeń. Chodziło o udowodnienie koncepcji, a nie o pokazanie gotowej metody ataku działającej w prawdziwym świecie.
Eksperci komentujący badanie zwracali uwagę, że scenariusz był skrajnie mało praktyczny. To raczej demonstracja możliwości niż realne zagrożenie, które jutro pojawi się w typowym laboratorium.
Ale tu właśnie tkwi sens takich badań. One nie pokazują, co jest masowym problemem dziś. Pokazują, gdzie mogą pojawić się ryzyka jutra.
Dlaczego ten eksperyment jest ważny?
Bo granica między światem fizycznym, biologicznym i cyfrowym robi się coraz cieńsza.
Nowoczesne laboratoria korzystają z automatycznych sekwencerów, robotów, systemów bazodanowych, chmury, algorytmów analitycznych i oprogramowania do interpretacji wyników. Próbka biologiczna nie kończy już życia pod mikroskopem. Trafia do systemu informatycznego jako dane.
A skoro trafia do systemu jako dane, musi być traktowana jak potencjalnie niebezpieczne wejście.
To podstawowa zasada cyberbezpieczeństwa: nie ufaj danym tylko dlatego, że pochodzą z nietypowego źródła.
Dla elektryków, automatyków i specjalistów IT to znajomy schemat. Czujnik, sterownik, kamera, licznik energii, falownik, system BMS czy urządzenie laboratoryjne też generują dane. Jeżeli system źle je przetwarza, mogą stać się punktem wejścia do ataku.
Sekwencjonowanie DNA tanieje, danych przybywa
Jeszcze kilkanaście lat temu badanie genomu było ekstremalnie drogie i dostępne głównie dla największych ośrodków badawczych. Dziś koszty spadły radykalnie, a analiza materiału genetycznego staje się coraz bardziej powszechna.
To oznacza ogromny wzrost ilości danych biologicznych.
Takie dane trafiają do laboratoriów, firm biotechnologicznych, baz medycznych, projektów badawczych i usług konsumenckich. Im więcej automatyzacji i cyfryzacji, tym większe znaczenie ma bezpieczeństwo całego łańcucha przetwarzania.
Nie chodzi tylko o prywatność danych genetycznych, choć to osobny ogromny temat. Chodzi także o bezpieczeństwo systemów, które te dane odczytują, analizują i przechowują.
Biologia jako kolejny front cyberbezpieczeństwa
Eksperyment z DNA pokazuje szerszy trend: cyberbezpieczeństwo przestaje dotyczyć wyłącznie komputerów w biurze.
Coraz więcej urządzeń działa na styku świata fizycznego i cyfrowego. Dotyczy to energetyki, przemysłu, laboratoriów, medycyny, automatyki budynkowej, transportu i telekomunikacji.
Każde urządzenie, które zbiera dane z otoczenia i przekazuje je do systemu komputerowego, może stać się elementem ryzyka.
W przypadku laboratoriów biologicznych dane wejściowe mogą pochodzić z próbek DNA. W energetyce — z liczników i czujników. W automatyce — z wejść sterownika. W monitoringu — z obrazu kamery. W telekomunikacji — z pakietów sieciowych.
Zasada jest ta sama: oprogramowanie musi zakładać, że dane wejściowe mogą być błędne, zmanipulowane lub specjalnie przygotowane pod atak.
Co powinny zrobić laboratoria i firmy technologiczne?
Najważniejszy wniosek z eksperymentu nie brzmi: „bójmy się DNA”. Brzmi: „zabezpieczajmy oprogramowanie, które analizuje dane z nowych źródeł”.
W praktyce oznacza to potrzebę:
- regularnych aktualizacji systemów,
- audytów bezpieczeństwa oprogramowania laboratoryjnego,
- izolowania krytycznych środowisk,
- kontroli danych wejściowych,
- bezpiecznego programowania,
- monitorowania anomalii,
- segmentacji sieci,
- ograniczania uprawnień systemów analizujących próbki.
To standardowe zasady cyberbezpieczeństwa, tylko zastosowane w mniej oczywistym środowisku.
Bo komputer w laboratorium nadal jest komputerem. Nawet jeśli na biurku obok stoi pipeta zamiast klawiatury mechanicznej z RGB.
Czy takie ataki mogą stać się realne?
W najbliższej przyszłości prawdopodobnie nie będą powszechne. Są zbyt trudne, kosztowne i zależne od konkretnego oprogramowania oraz procedur laboratoryjnych.
Jednak wraz z rozwojem biotechnologii, automatyzacji i taniego sekwencjonowania DNA ryzyko będzie wymagało większej uwagi.
Historia cyberbezpieczeństwa zna wiele zagrożeń, które początkowo wydawały się akademicką ciekawostką, a później stawały się realnym problemem w skali przemysłowej.
Nie chodzi więc o panikę, lecz o wyciągnięcie wniosków wcześniej, zanim systemy biologiczne i informatyczne połączą się tak mocno, że zabezpieczenia trzeba będzie dokręcać po awarii.
Cyberbezpieczeństwo musi patrzeć szerzej
Badanie University of Washington to bardziej ostrzeżenie niż praktyczny atak. Pokazuje jednak, że dane mogą przyjmować formy, których jeszcze niedawno nikt nie traktował jako potencjalnego nośnika zagrożenia.
Złośliwy kod w DNA brzmi jak absurdalny eksperyment z pogranicza nauki i thrillera technologicznego. Ale jego sens jest bardzo konkretny: każdy system, który automatycznie przetwarza dane, musi być odporny na błędne i wrogie wejście.
Dla branży technicznej to ważna lekcja.
Nie wystarczy chronić komputera przed plikiem z e-maila. Trzeba myśleć o całym łańcuchu: urządzeniu, czujniku, danych, oprogramowaniu, sieci i użytkowniku.
Bo w nowoczesnym świecie nawet próbka w laboratorium może stać się częścią systemu informatycznego. A gdzie są dane, tam prędzej czy później ktoś sprawdzi, czy da się je wykorzystać niezgodnie z przeznaczeniem.
Materiał współtworzony z AI.






Komentarze (0)